
英伟达Rubin GPU详细架构首曝:性能10倍提升!
2026-07-26 【 字体:大 中 小 】
- 首页 > 技术文库 > 英伟达Rubin GPU详细架构首曝:性能10倍提升!
英伟达Rubin GPU详细架构首曝:性能10倍提升!
关键词:英伟达Rubin GPU
时间:2026-7-24 13:24:03 来源:网络
“
英伟达官方发布了Rubin GPU架构技术详解,这也是英伟达即将推出的Vera Rubin平台的核心计算单元。根据官方公布的数据,在单位能耗下,Rubin NVL72+Vera CPU的Agentic AI推理吞吐量,相比Blackwell NVL72+x86 CPU提升最高可达10倍。
”
英伟达官方发布了Rubin GPU架构技术详解,这也是英伟达即将推出的Vera Rubin平台的核心计算单元。
根据官方公布的数据,在单位能耗下,Rubin NVL72+Vera CPU的Agentic AI推理吞吐量,相比Blackwell NVL72+x86 CPU提升最高可达10倍。

Vera Rubin平台相比Blackwell的10倍智能体推理性能提升
完整的Vera Rubin NVL72机架由36个Vera CPU和72个Rubin GPU组成,有关Vera CPU我们已经介绍过,今天的重点是Rubin GPU。

整体来看,Rubin GPU采用台积电3nm N3P制程工艺,由两颗计算芯粒组成,通过NVIDIA高速片间互联接口NV-HBI统一在单个封装上。
整颗芯片集成3360亿个晶体管,拥有224个SM流处理器和896个Tensor Core张量核心,搭载第三代Transformer引擎,可提供最高50 PF的NVFP4推理性能。

Rubin GPU芯片架构框图
显存方面,Rubin集成最高288GB HBM4,共配置8组12-Hi堆叠,峰值带宽达22TB/s,相比Blackwell和Blackwell Ultra提升2.8倍。

Rubin内存带宽相比Blackwell提升2.8倍
此外,第六代NVLink提供3600GB/s扩展带宽用于GPU间全互联通信,NVLink-C2C提供1800GB/s用于CPU-GPU一致性通信,PCIe Gen6 x16提供256GB/s主机连接。
针对当前主流MoE(混合专家)模型的扩展瓶颈,Rubin增强了Tensor Memory Accelerator(TMA),通过优化描述符管理机制,可更高效地定位和调度专家权重,减少数据搬运开销。
多个内核还可为共享相同布局的张量保留统一描述符,在运行时直接通过TMA指令覆盖内存指针和步长等字段,减少元数据管理和数据搬运开销,让更多GPU时间用于实际推理计算。

Rubin简化MoE描述符管理机制,右为Rubin架构
Rubin另一项核心升级是Tensor Core,每时钟周期的K维度吞吐量翻倍,意味着更少的循环迭代次数,Blackwell需要4次K迭代的GEMM运算,Rubin只需2次即可完成,减少了循环开销并提高了Tensor Core利用率。

左为Blackwell,右为Rubin
长上下文注意力加速是Rubin的另一大升级,Rubin将激活稀疏化与自适应压缩结合,将中间数据加载为2:4稀疏格式,仅保存非零数据及对应元数据。
后续softmax和第二注意力GEMM均可基于非零值运算,同时保持最终输出仍为标准Dense格式,在不改变模型接口的前提下减少计算量和数据搬运。
此外,Rubin还提升了Softmax及指数运算性能,FP32吞吐达到GB300水平,是GB200的2倍;BF16/FP16吞吐相比GB200提升4倍,相比GB300提升2倍。

Rubin自适应压缩稀疏化
在内核间依赖调度方面,Rubin实现了比Blackwell更精细的协调,Blackwell启动允许Kernel更早开始工作,但仍需等待激活数据可用。
而Rubin支持瓦片级触发,允许后续Kernel在所需输入数据准备完成后即可提前启动,不用等待更大范围的工作完成,从而压缩GPU时间线中的空闲间隙。

上为Blackwell批量触发,下为Rubin瓦片级触发
GPU间通信方面,Rubin引入了计数写入(Counted Writes)机制用于设备发起的NVLink通信。传统GPU间数据传输需要额外的协调和同步步骤,计数写入则允许接收端GPU更高效地跟踪传输完成状态,减少同步延迟,让计算不必等待同步操作。

通过计数写入加速NVLink通信,左为Blackwell,右为Rubin
在机架级能效管理上,Vera Rubin NVL72将计算、网络、液冷、功率调节和智能功率平滑整合为单一执行域。系统通过集成储能模块,可吸收GPU瞬时功率波动,平均功耗降低约10%,50毫秒峰值功耗降低约20%。

英伟达还推出DSX OS操作系统,其中集成DSX MaxLPS,可统一管理GPU、机柜、液冷系统以及AI工作负载,可在相同功率预算下多部署最多40%的GPU。
上一篇:【“十五五”开局之年推进新一代通信网建设观察】
下一篇:【从一颗GPU到一条“Token生产链”:沐曦如何构建AI Infra生态闭环】
猜你喜欢
- 芯闻
- 芯品
- 方案
- 文章
- • 2吉瓦!AMD拿下Anthropic大单,并承诺投资50亿美元
- • Grace服务器出货数十万台,Vera CPU剑指2000亿美元市场
- • 三星混合键合HBM延至2029年,将与英伟达Feynman平台共同亮相
- • 纬创资通美国首家半导体工厂开业!投资7亿美元
- • 芯展速 AI90 固态硬盘显存化方案亮相:首 Token 延迟缩短至 1/50
- • Melexis扩展免代码单线圈风扇驱动器系列,强力赋能AI GPU散热
- • 同德、耕升推出新款 GeForce RTX 3060 12GB 显卡
- • Supermicro扩大边缘AI解决方案产品组合,推出针对低延迟推理与工业部署优化的英特尔平台
- • AI浪潮之巅:思瑞浦如何以全链路模拟芯片方案筑牢智算时代底座
- • 南芯科技发布面向算力芯片供电的多相DrMOS电源方案
- • 360环视实时性评估:GPU加速性能与AI拓展潜力-基于米尔RK3576
- • [原创]Renesas DA14706超高集成度的蓝牙 5.2单芯片解决方案
- • 英伟达Rubin GPU详细架构首曝:性能10倍提升!
- • 从一颗GPU到一条“Token生产链”:沐曦如何构建AI Infra生态闭环
- • 黄仁勋揭AI新时代蓝图:从GPU到AI工厂 英伟达如何重新定义未来运算?
- • AI引爆CPU新战事,2200亿美元市场群雄逐鹿
The End
免责声明:本文内容来源于第三方或整理自互联网,本站仅提供展示,不拥有所有权,不代表本站观点立场,也不构成任何其他建议,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容,不承担相关法律责任。如发现本站文章、图片等内容有涉及版权/违法违规或其他不适合的内容, 请及时联系我们进行处理。

猜你喜欢

经济型≠将就型!米思米轴承的“实惠又可靠”之道
2025-08-18
瑞萨电子推出高集成度LCD视频处理器,赋能新一代ASIL B等级车载显示系统
2025-03-27
无线通信新型超材料天线问世
2024-04-16
HOLTEK新推出HT42B216-1/316-1/416-1/536-1 CAN Bridge IC
2024-12-07
忆芯科技携PCIe 5.0高能效企业级SSD主控芯片STAR1500亮相ICCAD-Expo 2024
2024-12-16
G+D 和村田宣布推出全球首款符合 SGP.32 和 iSIM 标准的集成式连接模块
2024-11-09
u-blox利用新款小型LTE Cat 1bis蜂窝通信模块助推全球通信发展
2024-07-16
设备可靠性标杆!r科1N4148W二极管满足的性能需求
2024-09-03
米尔RK3576核心板首现瑞芯微展台!8核6T高算力赋能工业AI智能化
2024-09-27
移远通信,开启透明天线中的“创新密码”
2024-03-21
最新文章
相关推荐

三个月吸金近15亿,光联芯科领跑片间光互连赛道
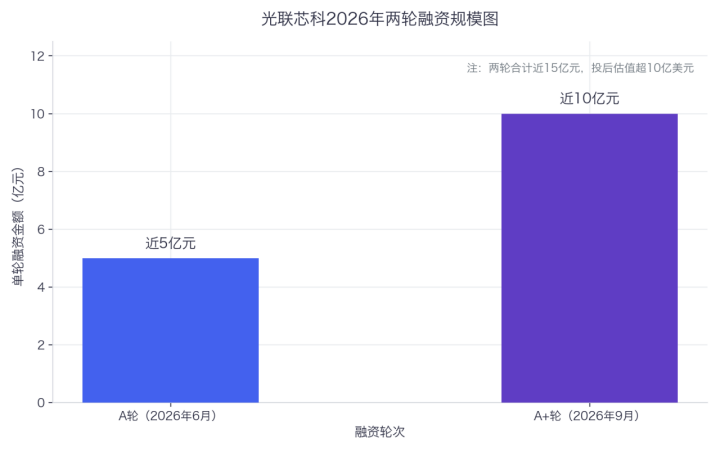
首页 > 技术文库 > 三个月吸金近15亿,光联芯科领跑片间光互连赛道 ...
车灯内卷时代,出路在何方?安瑞光电双轮驱动,加速全球出圈
首页 > 技术文库 > 车灯内卷时代,出路在何方?安瑞光电双轮驱动,加速全球出圈...
最终盘点:关于RS-485的十大要点
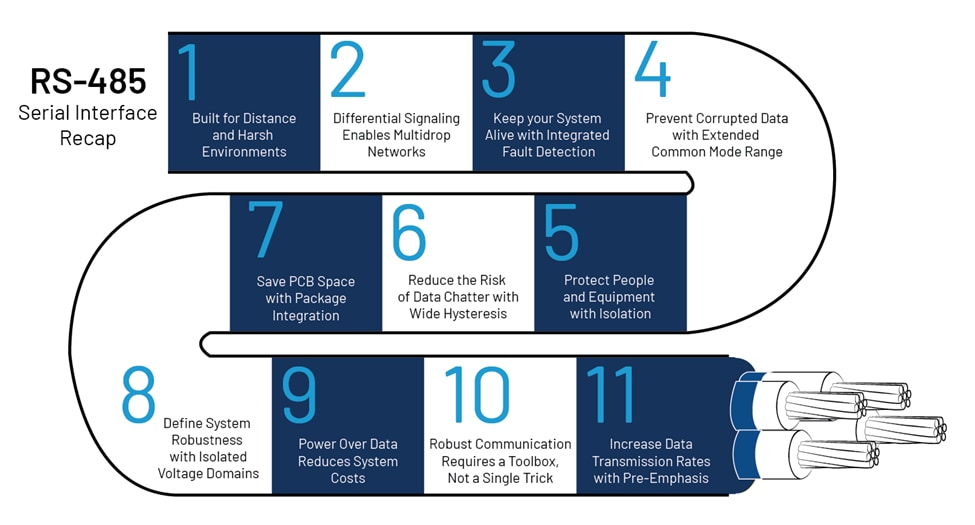
首页 > 技术文库 > 最终盘点:关于RS-485的十大要点 ...
CIOE 2026观察:从纳米到光年,一束光的“连接带”加速成型
首页 > 技术文库 > CIOE 2026观察:从纳米到光年,一束光的“连接带”...
光刻产业开启”双线迭代“:High-NA EUV与12英寸光掩模
首页 > 技术文库 > 光刻产业开启”双线迭代“:High-NA EUV与12英...
芯连青山绿水,智护万千生灵——宸芯MNet自组网技术助力野生动物保护
首页 > 技术文库 > 芯连青山绿水,智护万千生灵——宸芯MNet自组网技术助力...
Eddie Ramirez:服务器市场Arm优势有三 多元化方案提供更多选择性
首页 > 技术文库 > Eddie Ramirez:服务器市场Arm优势有三 多...
苹果首款折叠iPhone发布 果链迎来结构性重估:谁在受益,谁在承压?
首页 > 技术文库 > 苹果首款折叠iPhone发布 果链迎来结构性重估:谁在受...
前苹果NPU全建制高管团队押注端侧通用计算平台,成立一年已获三轮产业方领衔近10亿投资
首页 > 技术文库 > 前苹果NPU全建制高管团队押注端侧通用计算平台,成立一年...
服务器CPU生产挤占PC产能,英特尔是否该“外包解困”?
首页 > 技术文库 > 服务器CPU生产挤占PC产能,英特尔是否该“外包解困”?...
大家都在看
三个月吸金近15亿,光联芯科领跑片间光互连赛道
车灯内卷时代,出路在何方?安瑞光电双轮驱动,加速全球出圈
最终盘点:关于RS-485的十大要点
CIOE 2026观察:从纳米到光年,一束光的“连接带”加速成型
光刻产业开启”双线迭代“:High-NA EUV与12英寸光掩模
芯连青山绿水,智护万千生灵——宸芯MNet自组网技术助力野生动物保护
Eddie Ramirez:服务器市场Arm优势有三 多元化方案提供更多选择性
苹果首款折叠iPhone发布 果链迎来结构性重估:谁在受益,谁在承压?
前苹果NPU全建制高管团队押注端侧通用计算平台,成立一年已获三轮产业方领衔近10亿投资
服务器CPU生产挤占PC产能,英特尔是否该“外包解困”?
