
谷歌 DeepMind 新研究强化思维链训练,让 AI 语言模型不再“纸上谈兵”
2025-05-20 【 字体:大 中 小 】
“科技媒体 marktechpost 昨日(5 月 19 日)发布博文,报道称谷歌 DeepMind 团队联合约翰・开普勒林茨大学 LIT AI 实验室,通过强化学习微调(RLFT)技术,提升语言模型的决策能力。
”科技媒体 marktechpost 昨日(5 月 19 日)发布博文,报道称谷歌 DeepMind 团队联合约翰・开普勒林茨大学 LIT AI 实验室,通过强化学习微调(RLFT)技术,提升语言模型的决策能力。
援引博文介绍,基于海量互联网数据训练的语言模型已展现出超越文本处理的决策潜力,可以通过内部知识推理,在交互环境中做出行动选择。
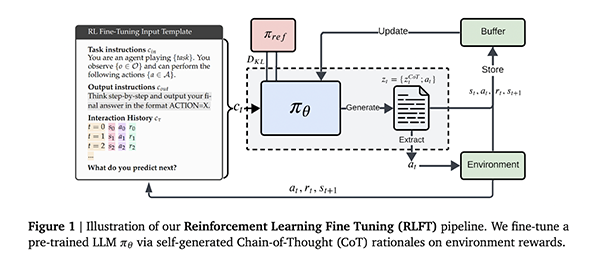
不过这些语言模型在决策过程存在显著缺陷:模型能推导正确策略却无法执行(knowing-doing gap,纸上谈兵),过度偏好短期高回报选项(greediness,贪婪选择),较小模型还会机械重复常见动作(frequency bias,频次偏见)。
传统强化学习方法如 UCB 算法虽能平衡探索与利用,但难以解决模型内在的推理-行动脱节问题。
DeepMind 团队创新采用强化学习微调技术,以模型自生成的思维链作为训练信号,系统会评估每个推理步骤对应的行动奖励,促使模型优先选择逻辑自洽且实际高效的行动方案。
具体实施时,模型根据输入指令和行动-奖励历史生成包含推理过程与动作的序列,通过蒙特卡洛(Monte Carlo)基线评估和广义优势估计进行优化;无效动作会触发惩罚机制,而奖励塑造技术既保证输出格式规范,又保留探索空间。
在 10 臂的多臂老虎机(multi-armed bandit,MAB,有拥有 N 根拉杆的老虎机,拉动每一根拉杆都对应一个关于奖励的概率分布)测试中,2B 参数模型的动作覆盖率提升 12 个百分点;面对 20 臂时改善幅度虽小但仍有意义,其频次偏见率从 70% 骤降至 35%。

井字棋实验中,模型对阵随机对手的胜率提升 5 倍,与最优蒙特卡洛树搜索代理的对战平均回报从-0.95 归零。值得注意的是,27B 大模型生成正确推理的概率达 87%,但未微调时仅 21% 会执行最优动作,该强化学习微调有效缩小了这一差距。
The End
免责声明:本文内容来源于第三方或整理自互联网,本站仅提供展示,不拥有所有权,不代表本站观点立场,也不构成任何其他建议,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容,不承担相关法律责任。如发现本站文章、图片等内容有涉及版权/违法违规或其他不适合的内容, 请及时联系我们进行处理。

猜你喜欢

金升阳推出3W-15W 低漏电流、高隔离耐压DC/DC医疗电源
2025-04-03
一种简单直观的模拟电路温漂分析方法
2026-09-09
村田实现超小型0402M尺寸、支持100V额定电压的低损耗片状多层陶瓷电容器商品化
2024-02-20
意法半导体高性能微控制器为智能家居和工业系统新创新扫清障碍
2024-03-18
千岛群岛7.5级地震(3.5级地震相当于什么)
2023-10-02
境憧萍夹缕贩⒉绩 SC7506 36V 双通道 高精度运算放大器
2024-07-17
光为什么能穿过比它还小的孔?——超表面红外滤光片的异常光透射
2026-10-24
贸泽电子开售支持图像处理和边缘AI加速的Advantech VEGA-P110 PCIe Intel Arc A370M嵌入式GPU卡
2024-03-08
对话芯爱科技董事长张垂弘:当“第一乐章”奏响,如何梯度化布局高端基板?
2026-10-18
京瓷推出冷却效果提升21%的新型Peltier热电模块
2024-08-07
最新文章
相关推荐

详解 Cascode SiC JFET 在 LLC 中的应用:优势与 dv/dt 控制

首页 > 技术文库 > 详解 Cascode SiC JFET 在 LLC 中的...
纳芯微高级工程师贾晓雨:智能底盘芯片如何从技术路线走向量产?
首页 > 技术文库 > 纳芯微高级工程师贾晓雨:智能底盘芯片如何从技术路线走向量...
工厂里平常的一天,直到红色警报闪烁……
首页 > 技术文库 > 工厂里平常的一天,直到红色警报闪烁…… ...
算力狂飙下的封装突围:华天先进攻坚高阶封测国产化
首页 > 技术文库 > 算力狂飙下的封装突围:华天先进攻坚高阶封测国产化 ...
AI拉动12英寸硅片量价齐升 涨价红利2027年集中释放
首页 > 技术文库 > AI拉动12英寸硅片量价齐升 涨价红利2027年集中释放...
5G射频迷局:为何传统频谱分析仪难以捕捉现代射频干扰?
首页 > 技术文库 > 5G射频迷局:为何传统频谱分析仪难以捕捉现代射频干扰? ...
锁相环:参考振荡器与时钟分配缓冲器的选型
首页 > 技术文库 > 锁相环:参考振荡器与时钟分配缓冲器的选型 ...
英迪芯微,一家中国车规芯片企业的创业坚守和二次曲线
首页 > 技术文库 > 英迪芯微,一家中国车规芯片企业的创业坚守和二次曲线 ...
AI质检迈入ACI认知检测时代:工业视觉模型实现产线持续自学习
首页 > 技术文库 > AI质检迈入ACI认知检测时代:工业视觉模型实现产线持续...
工业机器人如何学习成为灵巧的机器
首页 > 技术文库 > 工业机器人如何学习成为灵巧的机器 ...
