
小鹏集团发布TuringViT高效视觉编码器
2026-07-26 【 字体:大 中 小 】
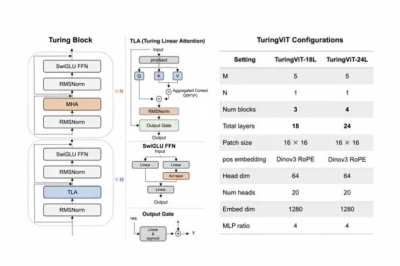 TuringViT 共推出两个规格版本:
TuringViT-18L包含 3 组 Turing Block(共 15 层 TLA+3 层 MHA),主打动态分辨率下的高效部署;
TuringViT-24L包含 4 组 Turing Block(共 20 层 TLA+4 层 MHA),在保持线性计算主导的前提下进一步提升表征能力。
实测数据显示,随着输入分辨率提升,TuringViT 的延迟增长曲线远平缓于标准 softmax ViT,高分辨率下的效率优势愈发显著。在 1536×1536 分辨率下,TuringViT-18L 的推理吞吐量达到 Seed1.5-ViT 的 3.04 倍,相比 SigLIP2-ViT-L 提升 2.16 倍,为高分辨率感知、多摄像头输入、长时序视频处理的端侧部署扫清了核心障碍。
不同于行业“堆数据规模”的粗放路线,TuringViT 打造了 VISTA-Curation 多模态数据治理流水线,通过提升单样本的监督价值实现数据效率的量级提升,从“用更多数据”转向“用更优质的监督”。
针对图文数据,流水线通过三步精细化筛选实现质量升级:
第一步过滤低分辨率、模糊、低纹理的低质量图片;
第二步通过多模型、多提示词生成多样化候选字幕,并交叉验证视觉一致性;
第三步在统一对比池中通过相对图文对齐度、文本信息量、歧义度综合打分,筛选出视觉贴合度高、语义信息密度高的优质标注,淘汰模糊、泛化、弱对齐的样本。
针对视频数据,流水线同样进行全流程治理:先将长视频切分为连续短片段并均匀采样代表帧;再通过语义一致性与运动一致性双重过滤,保留语义连贯、变化信息有效的片段;最后融合局部帧级细节字幕与全局时序语义字幕,生成具备变换感知能力的视频标注,让模型从连续画面中学习更鲁棒的视觉表征。
最终,TuringViT 仅用 0.85B 图文对(约为 SigLIP2-L 训练数据规模的 10%),便在 ImageNet-1K 等六项零样本分类基准上取得 83.6% 的平均准确率,超越使用 10B 数据训练的主流开源基线;在 COCO、Flickr30K 图文检索任务上同样优势显著,真正实现了“十分之一数据,更优效果”的突破。
TuringViT 还采用四阶段渐进式原生动态分辨率训练范式,从预训练之初就适配下游 VLM / VLA 的输入特性,告别“固定分辨率预训练 + 事后适配”的传统模式。
在智能驾驶领域,TuringViT 是第二代 VLA 模型的核心视觉编码器,负责处理多路环视摄像头的高分辨率、多帧动态道路场景输入,为预测式世界模型提供视觉 token。
面向智能座舱与驾泊一体化场景,TuringViT 的 VLM 原生特性让视觉特征与语言模型实现更高效的对齐,可以提供更高的识别精度、不同画幅和比例的视觉输入,以支撑更多未来的车辆与用户交互的丰富座舱功能。
在小鹏 IRON 人形机器人的技术体系中,TuringViT 充当着“视觉视网膜”的核心角色,为具身智能提供物体细粒度识别、空间关系理解、可操作区域检测、动态环境追踪等基础感知能力。
(来源:我爱公关)
The End
免责声明:本文内容来源于第三方或整理自互联网,本站仅提供展示,不拥有所有权,不代表本站观点立场,也不构成任何其他建议,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容,不承担相关法律责任。如发现本站文章、图片等内容有涉及版权/违法违规或其他不适合的内容, 请及时联系我们进行处理。

猜你喜欢

存在违法行为!海尔消金被罚245万元
2025-07-29
精华油实现“科技力”,逐本让“轮廓美”触手可及
2026-06-28
扬州爱奇艺乐园新年开门红 龚宇预计单日峰值收入还有1-2倍增长空间
2026-03-03
当“去班味”越来越被需要:杉杉奥莱的春夏解法
2026-05-03
两份 “凯度” 力量,一份新厨电白皮书
2026-09-06
经期私护选对款,高洁丝蔓越莓益生力太懂女生
2026-02-13
赛道硝烟再起!元气森林冰茶以三大核心优势定义新一代冰茶
2025-09-19
胖东来回应关闭多家门店言论:严重误导
2025-06-24
天梭怀旧经典1938天文台:2824机芯才是真“经典”
2024-01-02
优步全球媒介代理格局落定
2026-07-26
最新文章
相关推荐

梦龙冰淇淋公司三季度营收增长12.1%,天气因素让中国市场受挫,却助力欧洲市场销量大
刚刚过去的三季度是冰淇淋的消费旺季,得益于欧洲夏季热浪、产品创新等因素的影响,全...
闻震令而动 聚志愿之力——西藏志愿服务力量驰援地震灾区
2026年10月22日22时33分,西藏自治区那曲市巴青县发生7.0级地震,震源...
老干妈用AI:省下了成本,留得住风味吗?

要理性看待老干妈用AI这件事,需要先把企业披露的事实与传播过程中附加的解释区分开...
八一少年——第二届国防教育主题运动会暨“大沩杯”阳光跑跑团启动仪式

勇踏长征攻坚路,奔跑砺志向未来秋风拂过绿茵赛场,少年意气奔涌飞扬。10月23日,...
苹果终于向触控妥协,但它并不想把 MacBook 变成 iPad
苹果终于做出了一台可以用手指操作屏幕的 MacBook Pro,如果把时间拨回十...
米元力亮相新华社好物甄选,品牌发展迎来新进展
近日,国际营养品牌米元力(AlphaMeta)进入中国市场后,持续推进品牌建设与...
双汇急需另一根火腿肠
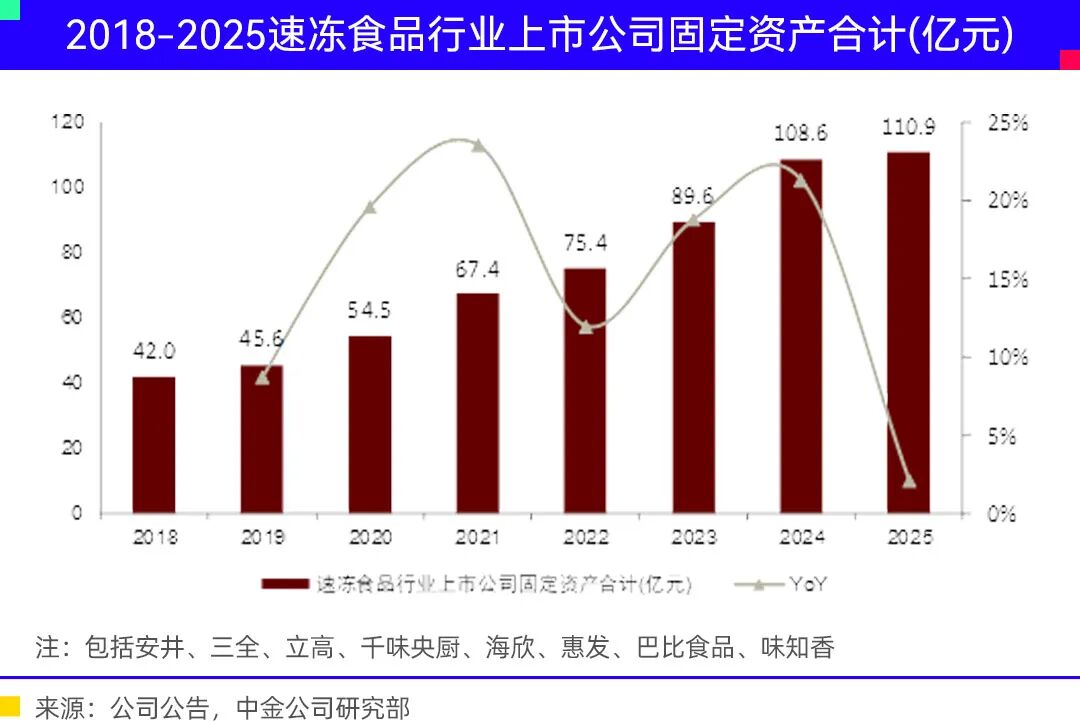
最近,舆论关注双汇的焦点,当然是“林可霉素残留超标”事件。对于投资者和产业观察者...
关爱银龄健康 白云山花城药业韶关公益行动 让中医药温暖粤北烟火
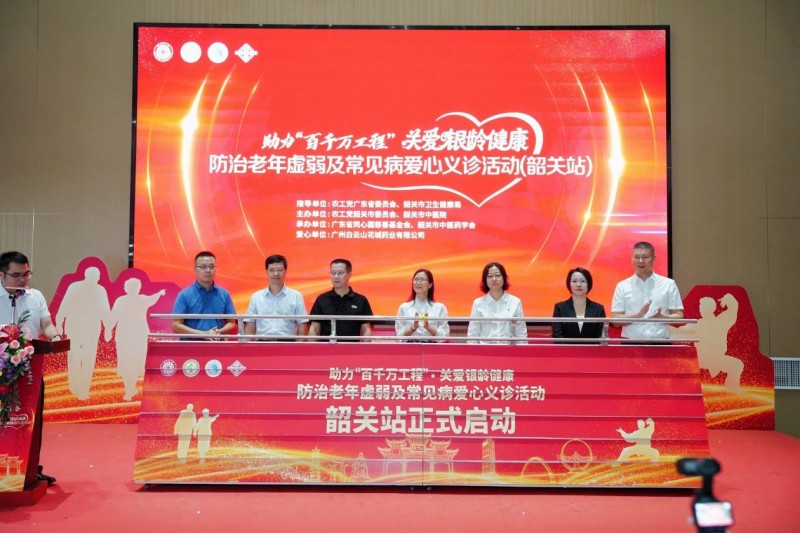
名医义诊、中医理疗、药膳食鉴、文化科普从诊室走向市井烟火,化为一场可触可感的中医...
网友发帖寻人,拉夫威尔省下百万宣传费
拉夫威尔是专业宠物品牌,客单价大多在300-500元区间,主推胸背、项圈、牵引绳...
红果、Seedance 与字节:短剧观察札记
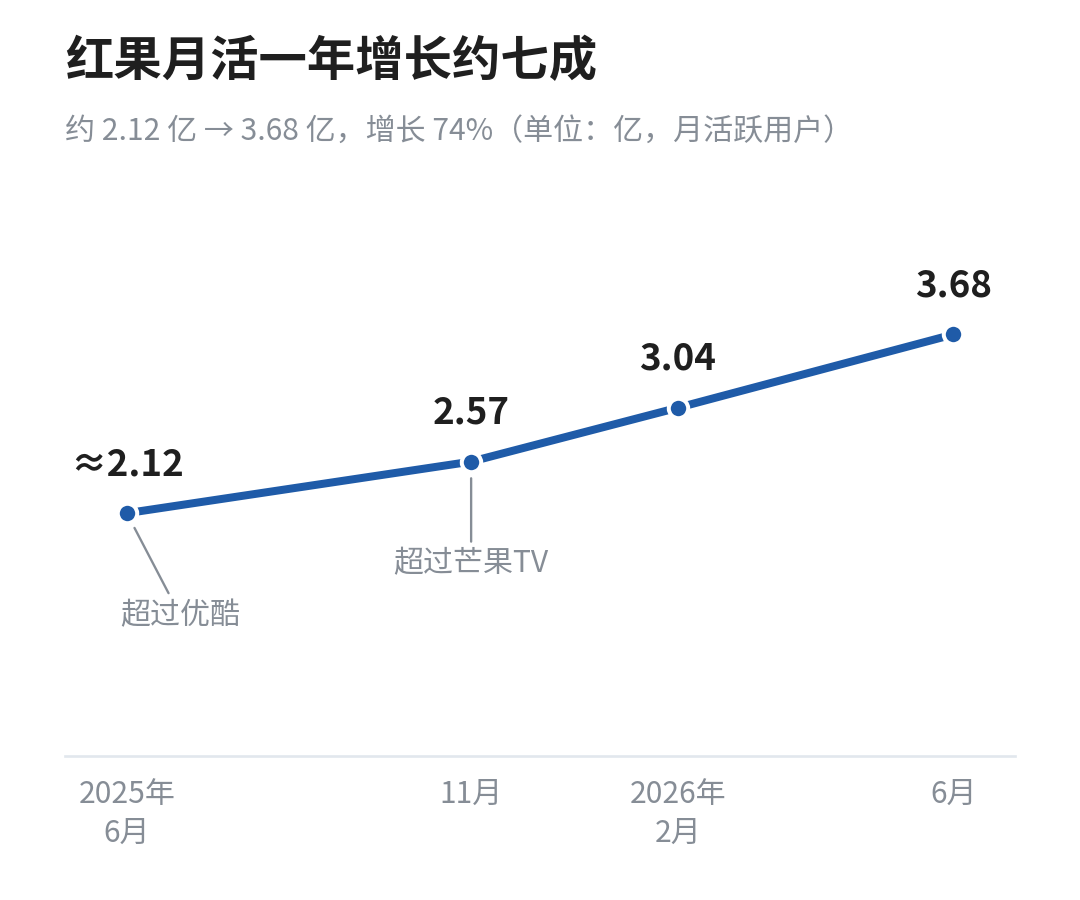
先校准一个说法:字节确实同时握住了短剧的分发入口和最先进的生产工具之一,但它并没...
