
边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未来需求
2026-10-15 【 字体:大 中 小 】
- 首页 > 技术文库 > 边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未来需求
边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未来需求
关键词:人工智能嵌入式
时间:2026-10-14 15:01:37 来源:意法半导体
“
随着微控制器利用嵌入式神经处理单元(NPU)加速边缘端的人工智能推理,数据搬移开销成为进一步发展的障碍。存内计算是一种有效的加速技术,但需要与底层技术紧密协同。
”
作者:Edwin Hilkens,意法半导体STM32 产品市场经理;
François de Rochebouët,意法半导体人工智能解决方案市场负责人
随着微控制器利用嵌入式神经处理单元(NPU)加速边缘端的人工智能推理,数据搬移开销成为进一步发展的障碍。存内计算是一种有效的加速技术,但需要与底层技术紧密协同。
加速边缘人工智能
边缘人工智能已进入 Gartner 技术成熟度曲线的生产成熟期,具有影响力的新产品正不断进入市场,改变人们的生活与工作方式。边缘端被描述为物理信号转化为数据的地方。如今,人工智能带来了前所未有的能力,可以即时解读观测结果,并确定准确、及时的响应。
将神经处理引入边缘平台,使产品开发人员能够在资源受限、基于微控制器的系统中实现高效计算机视觉、关键词检测、模式匹配、异常检测和活动跟踪等功能。这推动了智能防护服、工业安全系统、预测性维护传感器、质量检测系统等众多设备的重大变革。
如今,将人工智能能力嵌入微型边缘平台的探索,始于对神经网络工作负载进行调整,使其适应 Cortex-M 内核等普通嵌入式 CPU 的限制。这类处理器可以执行重复的乘加运算和内存访问,但显然并非为此类任务而优化。
通过量化来减少数据占用和搬移开销,并对算子处理及内存布局进行精心优化,嵌入式平台可以承载二维卷积、关键词识别和异常检测等基础人工智能功能。工具链也开始相应调整:例如,ST 在 STM32Cube 生态系统中推出 AI Studio,帮助开发人员选择并调优适合在所选硬件上运行的模型。
然而,以这种方式处理更强大、更复杂工作负载的空间非常有限,尤其是在嵌入式平台面临严格的尺寸、功耗和成本约束时。实际测量显示,可实现的最高计算效率仅约为每瓦 0.1 万亿次运算(TOPS/W)。
嵌入式神经处理
为了加速推理并为人工智能工作负载提供更高的 TOPS/W,前沿的 MCU 如今在专用硬件中集成了专门设计的神经处理单元(NPU)。
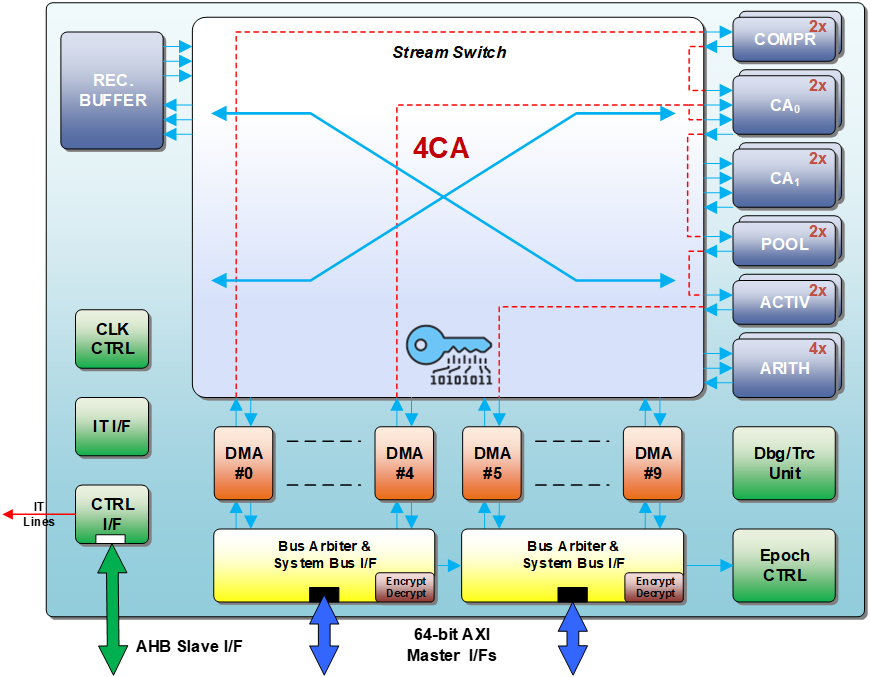
ST 的 Neural-ART 加速器(图 1)是新兴嵌入式 NPU 的一个例子,旨在推动更高性能的边缘人工智能。其核心是用于流处理的非阻塞交换结构,并配有数据流控制和路由等硬件。此外,它还集成专用 AI 加速器、DMA 引擎和中断生成器,可与主机解耦执行。

图 1. 面向数据流处理架构的 Neural-ART 加速器 NPU
ST 的 NPU 架构支持从数十亿次运算每秒(GOPS)扩展到数万亿次运算每秒(TOPS)。多岛配置可实现广泛优化,包括通过电压和频率调节来优化功耗,以及支持多模型计算,从而根据工作负载和关键程度灵活分配运动识别或低需求网络任务等模型。
尽管集成在微控制器中的 NPU 功能更强大,也非常适合微型边缘人工智能,但它们必须在资源极其有限的条件下运行。最大限度地复用本地数据是首要任务,同时保持计算性能、路由和接口带宽之间的平衡也至关重要。三者中任何一项相对不足,都会形成限制系统性能的瓶颈。
基于目前可用的 40nm、28nm、18nm FDSOI 和 16nm FinFET 制造工艺,预计仅依靠 NPU 加速,神经处理基准可达到 1–5 TOPS/W 和 0.1–2 TOPS/mm²。这些指标还取决于 NPU 架构和应用运行模式。然而,预期的市场需求要求未来五年内性能和效率提升至 50–200 TOPS/W。与此同时,扩展 NPU 性能需要增加额外处理模块和更宽互连等硬件,会增大芯片面积和功耗。因此,需要采用不同的方法。
嵌入式存内计算
尽管神经处理的核心计算原理各不相同,其底层硬件行为仍与传统系统相同。虽然 NPU 通过大量小型顺序单元实现并行处理,但内存仍是被动的,在处理单元中执行指令时,必须通过带宽严格受限的接口搬移数据。
存内计算(IMC)是高性能计算领域的一项前景广阔的技术,非常适合神经处理中的向量乘法等线性运算。为边缘平台开发 IMC,有望在功耗效率和计算密度方面实现大幅提升,即以 TOPS/W 和每平方毫米硅面积的 TOPS 衡量,从而满足未来边缘人工智能性能预期(图 2)。

图 2. 利用存内计算进一步加速嵌入式神经处理器,将提升边缘人工智能的性能与效率
实现 IMC 的方式不止一种,而且该技术仍处于开发周期的早期阶段。数字存内计算(DIMC)在存储器内部实现乘法器。在模拟存内计算中,神经网络权重编码在存储单元状态中,并基于基尔霍夫定律或欧姆定律等模拟物理现象原位完成乘法运算。
数字存内计算
数字存内计算通常使用 SRAM 阵列实现,用于保存权重或小型张量,并与片上集成的乘加单元(MAC)等固定功能逻辑紧密耦合。DIMC 单元块是这种新型 NPU 内部兼具临时存储与计算功能的核心模块。编译器负责将运算分配给 NPU 及其内部 IMC 模块,并协调二者之间的数据移动。
内部 DIMC 单元块体积较小,每次计算都会重新加载权重。通过支持 Transformer、RNN(包括 GRU、LSTM)等任意复杂神经网络,并增强通常用于计算机视觉的 CNN 性能,DIMC 可以将边缘人工智能的应用扩展到时间序列分析等新领域。
然而,数字存内计算仍然需要搬移数据,并受到内存带宽限制和时钟相关吞吐量限制的影响。此外,还必须考虑数字乘法器占用的面积成本。
模拟存内计算
模拟存内计算适用于 SRAM 或嵌入式非易失性存储器(eNVM),包括基于电荷的闪存,以及基于电阻的相变存储器(PCM)和铁电存储器(F-RAM)。权重存储在单元的电荷状态或电导状态中,输出以电流形式求和;激活存储单元后,可一次完成矩阵—向量乘法。由于采用模拟电子技术,信号需要一定时间才能稳定,结果也可能受噪声、温度漂移等因素影响,因此需要进行补偿。

图 3. 模拟存内计算利用存储器中的电容或电阻元件生成点积;数字存内计算则在存储器中实现乘法器
IMC 消除了内存接口瓶颈,并在不增加面积成本的情况下实现并行处理。在模拟 IMC 中,存储阵列实际上就是计算单元,无需数字计算引擎。与传统处理器—内存交互相比,计算能耗可降低数个数量级,因此功耗效率成为其突出优势,同时还能实现高密度多级存储。另一方面,单元块尺寸决定应用映射效率:更大的单元块可提高每瓦 TOPS,但会牺牲面积利用率。数字 IMC 的密度较低,但由于可在 SRAM 中快速重新加载权重,因此能够处理超大规模网络。两种技术各有优势,同时投入二者的开发,可为边缘人工智能开发人员提供创建合理优化解决方案所需的灵活性。图 4 对比了数字和模拟 IMC 的加速能力、效率与精度。

图 4. 嵌入式 NPU 中的数字与模拟存内计算
性能提升潜力
应用开发人员和芯片厂商都认识到,仅依靠运行在传统 MCU 架构上的软件,甚至是配备神经网络加速器的 MCU,也无法实现满足未来边缘人工智能处理需求所需的性能跃升。数字 IMC,以及最终能够同时缓解数据搬移和数字处理传播延迟的模拟 IMC,为资源受限的嵌入式 MCU 上的神经处理指明了前进方向。最终,边缘人工智能的能效有望提升多达 100 倍(图 5)。

图 5. IMC 可提供满足未来边缘人工智能性能需求所需的加速能力
IMC 与工艺技术
IMC 设计与阵列的尺寸和形状、存储技术、布线及硬件布局有着内在联系。通过将计算有效迁移到器件物理层面,IMC 与硅片布局之间形成了不同于以往硬件加速器的紧密联系。硅片本身定义了计算。编译器则可负责将模型映射到可用计算结构,并协调各项可用资源。
从这一角度看,ST 专有的 Neural-ART 加速器提供了在未来几代边缘人工智能微控制器中嵌入高效 IMC 加速所需的工艺级控制能力与灵活性。
结论
嵌入式 NPU 已经成为推动边缘人工智能性能向前发展、满足未来应用需求的重要工具。然而,仅依靠当今 NPU 的潜力仍不足以实现所需的进一步加速。除原始计算速度外,以 TOPS/W 衡量的能效和以 TOPS/mm² 衡量的面积效率,都是主导性的性能指标。IMC 通过在数据所在的阵列内部、访问数据的同时执行计算,突破了内存带宽限制;只有计算结果会离开阵列。
数字和模拟 IMC 都是持续加速边缘端神经处理的可行且有效的策略。对于 MCU 厂商而言,要实现这些加速器,并提供开发人员充分发挥其潜力所需的工具,掌控 NPU 架构和制造工艺都至关重要。
上一篇:【深度拆解:实现优异HDR的三种核心方法】
下一篇:【电池包起火前 5 分钟, 英飞凌这颗气压传感器如何监测热失控?】
猜你喜欢
- 芯闻
- 芯品
- 方案
- 文章
- • 粤港澳大湾区首个量超智融合算力中心成立
- • 京东工业与AMD签署战略合作协议,推动“工业大模型+智算硬件”深度融合
- • 村田亮相2026云栖大会:以全链路技术方案助力AI数据中心高效供电与热管理
- • 金山科技旗下GP能源科技镍锌电池技术亮相秋电展 以双基地布局及快速规模化生产瞄准AI及云端数据中心后备电源市场
- • 新品发布!BIS-6960HG-A10支持海光C86-3G系列CPU,兼顾国产化与丰富扩展要求
- • 雷神首款 AI 移动工作站 AI Master M7000 开售:锐龙 AI Max+ 395 处理器,1.99 万元
- • 比银行卡还小!拿铁熊猫推出微型x86计算模块:69.6×60mm 最高115TOPS
- • Semtech树立224G光互连新标杆
- • 适配英伟达HSB标准 高云半导体推出边缘AI桥接解决方案,助力传感接口无感接入英伟达平台
- • NSSine™ MCU 串口性能优化实战:如何用 DMA 提升数据吞吐效率
- • 瑞萨DA14531开发问题及解决方案
- • 安路科技 DR1 FPSoC®高精度PTP时钟同步方案
- • 边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未来需求
- • MCU大厂接连出手,这个开源RTOS会一统天下吗?
- • AI算力狂飙!数据中心却被“四重瓶颈”卡死
- • AI 赋能边缘新局 · 产业转型全面启动 2026 研华嵌入式设计论坛圆满收官!
The End
免责声明:本文内容来源于第三方或整理自互联网,本站仅提供展示,不拥有所有权,不代表本站观点立场,也不构成任何其他建议,对本文以及其中全部或者部分内容、文字的真实性、完整性、及时性不作任何保证或承诺,请读者仅作参考,并请自行核实相关内容,不承担相关法律责任。如发现本站文章、图片等内容有涉及版权/违法违规或其他不适合的内容, 请及时联系我们进行处理。

猜你喜欢

筑梦山河·沙海戈壁中的绿色梦想
2023-10-25
IO-Link:实际应用中的功耗问题
2026-08-10
高/低电平复位电路区别
2025-06-01
思特威推出具有AOV快启功能的5MP高分辨率IoT图像传感器SC535IoT
2024-02-23
坚固、可靠的微型连接器:为下一代车辆注入活力
2025-05-22
格平科技发布行业首款一体化PFC模块
2024-03-04
汽车GMSL3视频传输链路中的Wi-Fi 5GHz射频耦合
2026-10-13
SiC Combo JFET技术概览与特性
2025-06-29
星曜半导体发布新一代90V高压射频天线调谐开关Tuner
2024-12-02
Coherent 高意推出用于硅光子收发器的高效激光器
2024-09-29
最新文章
相关推荐

AI算力的隐形瓶颈:光器件为何比GPU更早售罄?
首页 > 技术文库 > AI算力的隐形瓶颈:光器件为何比GPU更早售罄? ...
物理AI走向边端,爱芯元智AX8860补上国产大算力芯片哪块拼图?
首页 > 技术文库 > 物理AI走向边端,爱芯元智AX8860补上国产大算力芯片...
三大传感挑战,如何破局?

首页 > 技术文库 > 三大传感挑战,如何破局? ...
从消费电子到智能座舱:Cadence Tensilica 音频 DSP 在芯驰 X10 中的落地
首页 > 技术文库 > 从消费电子到智能座舱:Cadence Tensilica...
MCX C1系列MCU:为入门级设计带来先进模拟集成与灵活控制能力
首页 > 技术文库 > MCX C1系列MCU:为入门级设计带来先进模拟集成与灵...
边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未来需求
首页 > 技术文库 > 边缘人工智能中的性能扩展与平衡——嵌入式神经处理面临的未...
深度拆解:实现优异HDR的三种核心方法
首页 > 技术文库 > 深度拆解:实现优异HDR的三种核心方法 ...
电池包起火前 5 分钟, 英飞凌这颗气压传感器如何监测热失控?
首页 > 技术文库 > 电池包起火前 5 分钟, 英飞凌这颗气压传感器如何监测热...
2028上半年:台积电美国先进封装的总攻时刻
首页 > 技术文库 > 2028上半年:台积电美国先进封装的总攻时刻 ...
物联智能
首页 > 技术文库 > 物联智能 ...
